在Autoresearch日益普及的当下,单纯的方法堆叠与数据扩张所带来的边际贡献正在迅速衰减。真正具有学术生命力的选题,生长于领域内的真问题与新一代AI方法的交汇之处,并须能够在公开、可复现的平台上接受检验。团队着力打造的OnSite平台(onsite.com.cn)正逐步成为自动驾驶与交通研究领域的基础科研平台。上述工作既源自平台建设中的真实科学问题,其成果也将持续反哺OnSite在能力诊断、训测一体与三维场景生成榜单等方向的新一轮建设。会议论文只是阶段性成果,下一步仍需依托平台努力解决真实问题、真解决问题,力争形成更具学科影响力的长期贡献。
NeurIPS是全球人工智能与机器学习领域最具影响力的顶级旗舰会议之一,与ICML、ICLR并列为机器学习三大顶会,并被CCF列为A类国际学术会议。NeurIPS 2026论文录用率为25.7%,TOPS实验室共有4篇论文获大会录用。
DriveHierarchy: A Benchmark for Diagnosing VLM Driving Capabilities from Open-Loop Understanding to Closed-Loop Execution
作者:Chengkai Xu†、Jiaqi Liu†、Yicheng Guo†、Peng Hang、Jian Sun*
项目链接:http://perfectxu88.github.io/DriveHierarchy/
代码链接:https://github.com/PerfectXu88/DriveHierarchy
数据集链接:https://huggingface.co/datasets/ChengkaiXu/DriveHierarchy
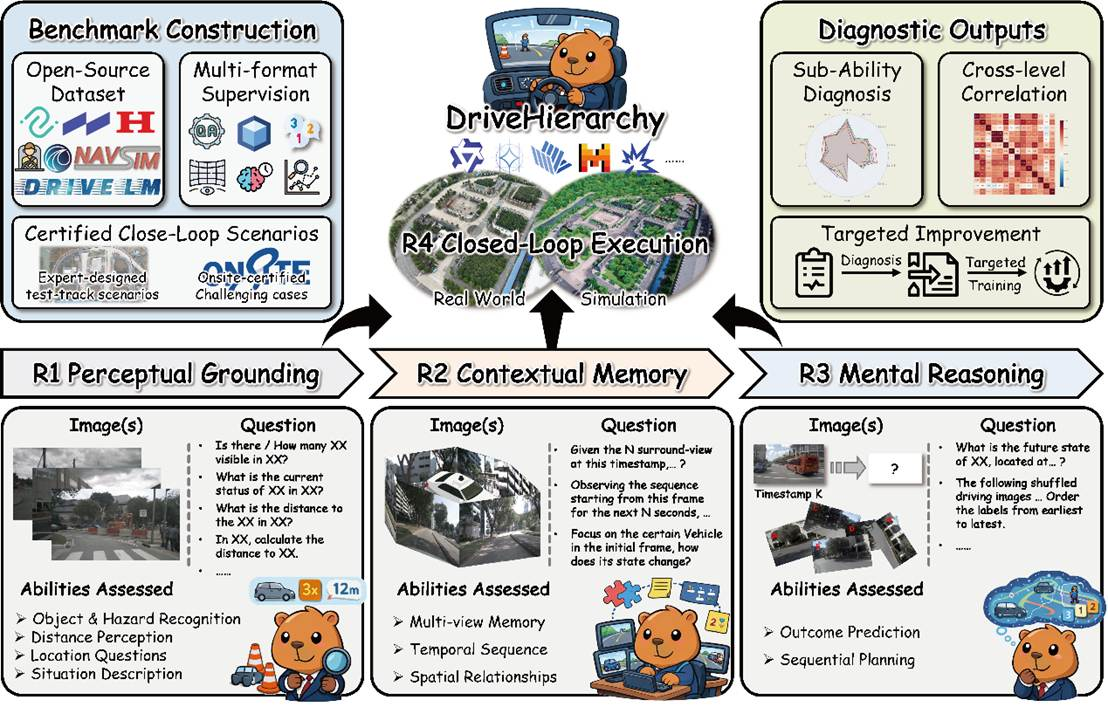
简介:随着视觉语言模型(VLM)加速进入端到端自动驾驶,一个核心问题日益突出:模型在开环测试中表现优秀,是否意味着真正具备闭环驾驶能力?针对传统评测“重结果、轻诊断”的局限,研究团队提出 DriveHierarchy,构建首个面向自动驾驶VLM、贯通开环理解—闭环执行的分层能力诊断框架,将驾驶智能划分为感知基础、上下文记忆、心理推理和闭环执行四个递进层级,并整合多个主流数据集,形成覆盖84,279帧、76,798组问答及100个闭环交互场景的统一评测体系。实验表明,DriveHierarchy不仅能够揭示不同能力与闭环驾驶表现之间的关系,还可据此开展针对性优化,在无需闭环监督的情况下显著提升模型性能,并在Bench2Drive等独立基准上展现良好的泛化能力。与此同时,课题组开发了零编程门槛的可视化场景编辑器,支持灵活构建复杂交互场景,显著降低闭环测试成本。未来,DriveHierarchy将进一步与OnSite自动驾驶公共服务平台及相关赛事建设结合,推动自动驾驶测试从“结果评价”向“能力诊断”演进,为端到端自动驾驶模型研发、安全验证和算法竞赛提供系统化技术支撑。
World Models as Adversaries: Multi-Agent Self-Play Fine-Tuning for Robust Motion Planning
作者:Tong Nie†、Yuewen Mei†、Junlin He、Yihong Tang、Jian Sun*、Wei Ma
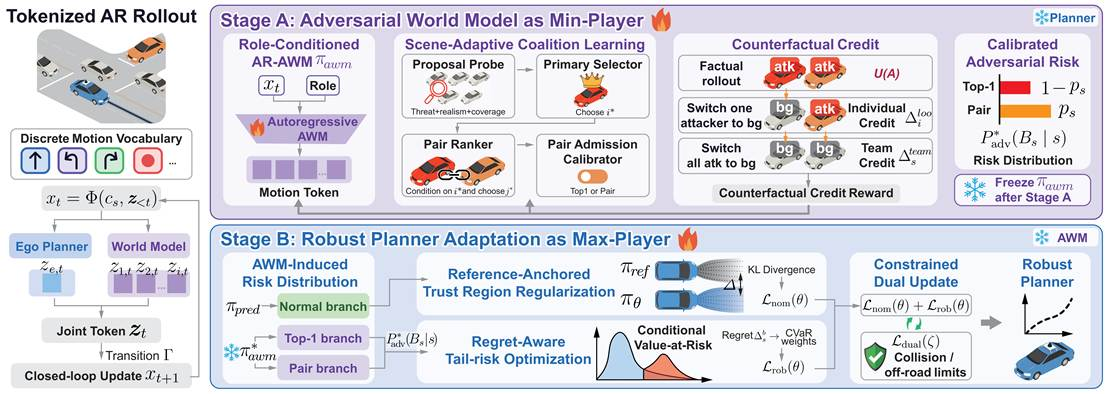
简介:罕见但关键的交互行为是制约自动驾驶可靠运行的重要挑战。现有规划模型主要从自然驾驶数据中学习,难以充分掌握多车协同引发的复杂风险;而依赖外部场景生成器的对抗训练,又难以与新一代生成式规划模型高效结合。针对这一问题,研究提出对抗世界建模框架AWM,将原本用于预测交通演化的世界模型转化为主动发现驾驶弱点的训练对手,建立风险发现与规划能力提升相衔接的自博弈学习范式。方法根据场景选择少数关键车辆,通过切换其正常与对抗角色、比较风险变化,辨识各车辆及其协同作用的贡献,从而生成具有针对性的高难度交互。随后固定对抗世界模型,以原有规划器为参照,集中改善高风险情境下的决策,同时约束行为偏移,保留常规驾驶能力。实验表明,相较基础规划器,微调后AWM在InterPlan扩展长尾交互测试集上的整体闭环评分相对提升16.7%,NuPlan典型困难交互场景的提升最高达26.9%;相较持续交替更新双方的自博弈基线,训练计算开销降低57.4%。所学对手还能够进一步接入闭环仿真器揭示不同类型规划器的潜在弱点。研究拓展了世界模型从交通模拟到主动风险发现与能力增强的作用,为自动驾驶安全学习提供了新路径,并可赋能OnSite平台“训测一体”功能建设。
Preference-Guided Adversarial Policy Optimization for Long-Tail Robust Driving
作者:Tong Nie、Yihong Tang、Junlin He、Yuewen Mei、Jie Sun、Lijun Sun、Wei Ma、Jian Sun*
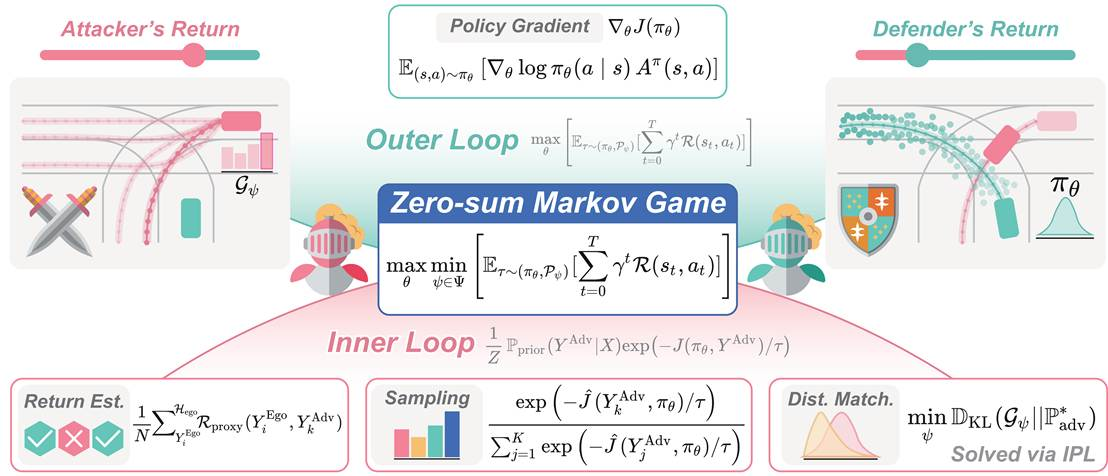
简介:自动驾驶系统的长尾风险学习面临一个持续变化的难题:随着驾驶能力提升,容易失效的情境也在不断变化,固定场景与既定攻击方式难以持续提供有效训练;同时,仅以碰撞为目标生成风险,又容易忽视通行受阻、偏离道路等其他能力缺陷。针对这一问题,研究提出闭环对抗训练框架ADV-0,将场景生成与驾驶策略优化统一为目标一致、交替更新的博弈过程。其核心思想是以驾驶系统自身的综合表现定义挑战,再用在线迭代偏好学习,持续比较哪些交通交互更能暴露当前策略的弱点,引导生成器在保留真实交通先验的基础上向这些薄弱环节演进。驾驶策略由此不断学习应对新的挑战,形成风险发现与能力提升相互促进的闭环。研究从理论上分析了这一过程的收敛性质与鲁棒性能下界,并在六种强化学习算法及两类运动规划模型上验证了方法的通用性。在基于Waymo真实交通数据的闭环仿真中,相比仅在原始日志回放环境中训练,六种强化学习算法在五类测试环境下的平均碰撞率相对降低25%,平均路线完成率相对提升10.2%;方法在独立长尾场景中也表现出更好的风险应对能力。该研究为从固定场景训练走向随能力变化而演进的安全学习提供了新的理论与方法,为OnSite平台及相关赛事提供了对抗训练基准算法支撑。
UniDBO: A Unified Dual-Branch One-Step Denoising Framework for Autonomous Driving Scenario Generation
作者:Da Zhao、Yuhang Chen、Jie Sun*、Jialin Fan、Jian Sun
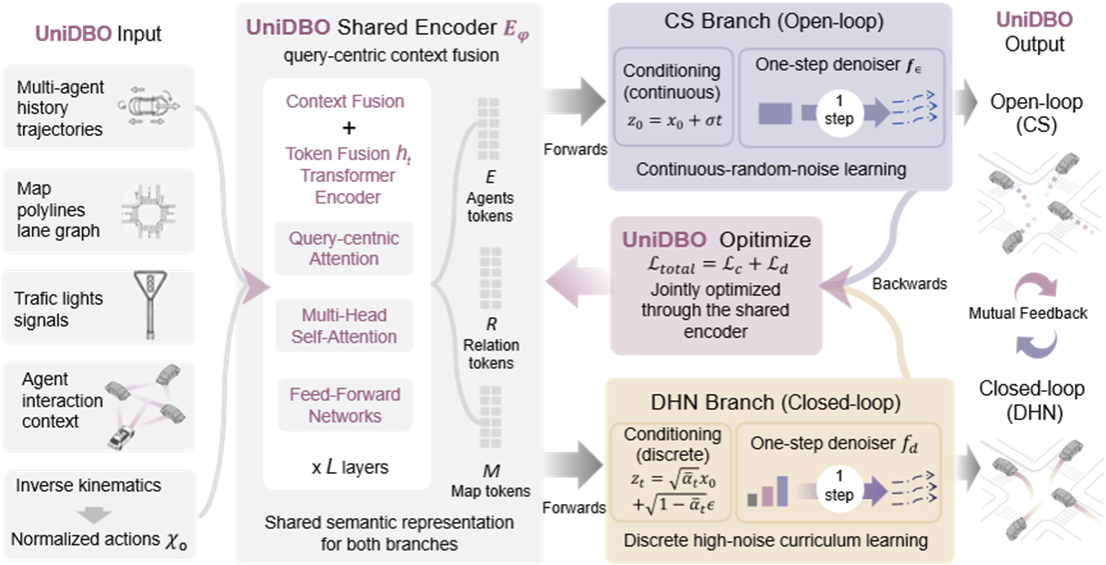
简介:真实、多样的交通场景是自动驾驶系统训练、测试与安全验证的重要基础。然而,现有基于自回归和扩散模型的闭环仿真方法难以兼顾开环预测精度、闭环鲁棒性与推理效率。针对这一核心问题,本研究提出统一双分支一步去噪框架UniDBO。其中,离散高噪声分支(DHN)通过渐进式高噪声课程学习,以高噪声下的一步控制恢复提升模型对闭环漂移的鲁棒性;连续尺度分支(CS)在连续噪声尺度上学习轨迹分布,并通过共享编码器提供辅助监督;推理时采用模式感知策略,按任务启用相应分支,以单步去噪实现交通场景生成。WOMD/Waymax实验表明,UniDBO能够兼顾开环预测精度、闭环鲁棒性与推理效率,INTERACTION零样本迁移验证了其跨域泛化能力,基于2025 OnSite场景智能生成赛道的测试则展示了其在自动驾驶闭环测试中的应用价值。该研究是TOPS课题组自动驾驶仿真研究方向上的新突破,为OnSite场景生成比赛(onsite.com.cn/#/dist/costomPage?menuId=307)提供了新的算法基准,也将深度赋能OnSite三维场景生成排行榜的建设。
电话:021-69583650 管理员邮箱:2015qgy@tongji.edu.cn
地址:上海市曹安公路4800号同济大学交通学院 邮编:201804
 TOPS课题组 页面浏览465,829次/访客70,123人次


