2026年9月23日,TOPS第188期组会顺利举行。本次组会由24级硕士潘昱蓉、连邦安、冯华越、修晓煊分别作《考虑主动干预场景的自动驾驶决策算法增强》《高度复杂交通场景交互行为建模与仿真》《面向端到端自动驾驶训测闭环的自适应场景生成方法研究》《面向自动驾驶训练的跨域仿真场景迁移生成方法研究》主题汇报。课题组师生参加了本次组会。
潘昱蓉(24级硕士):考虑主动干预场景的自动驾驶决策算法增强
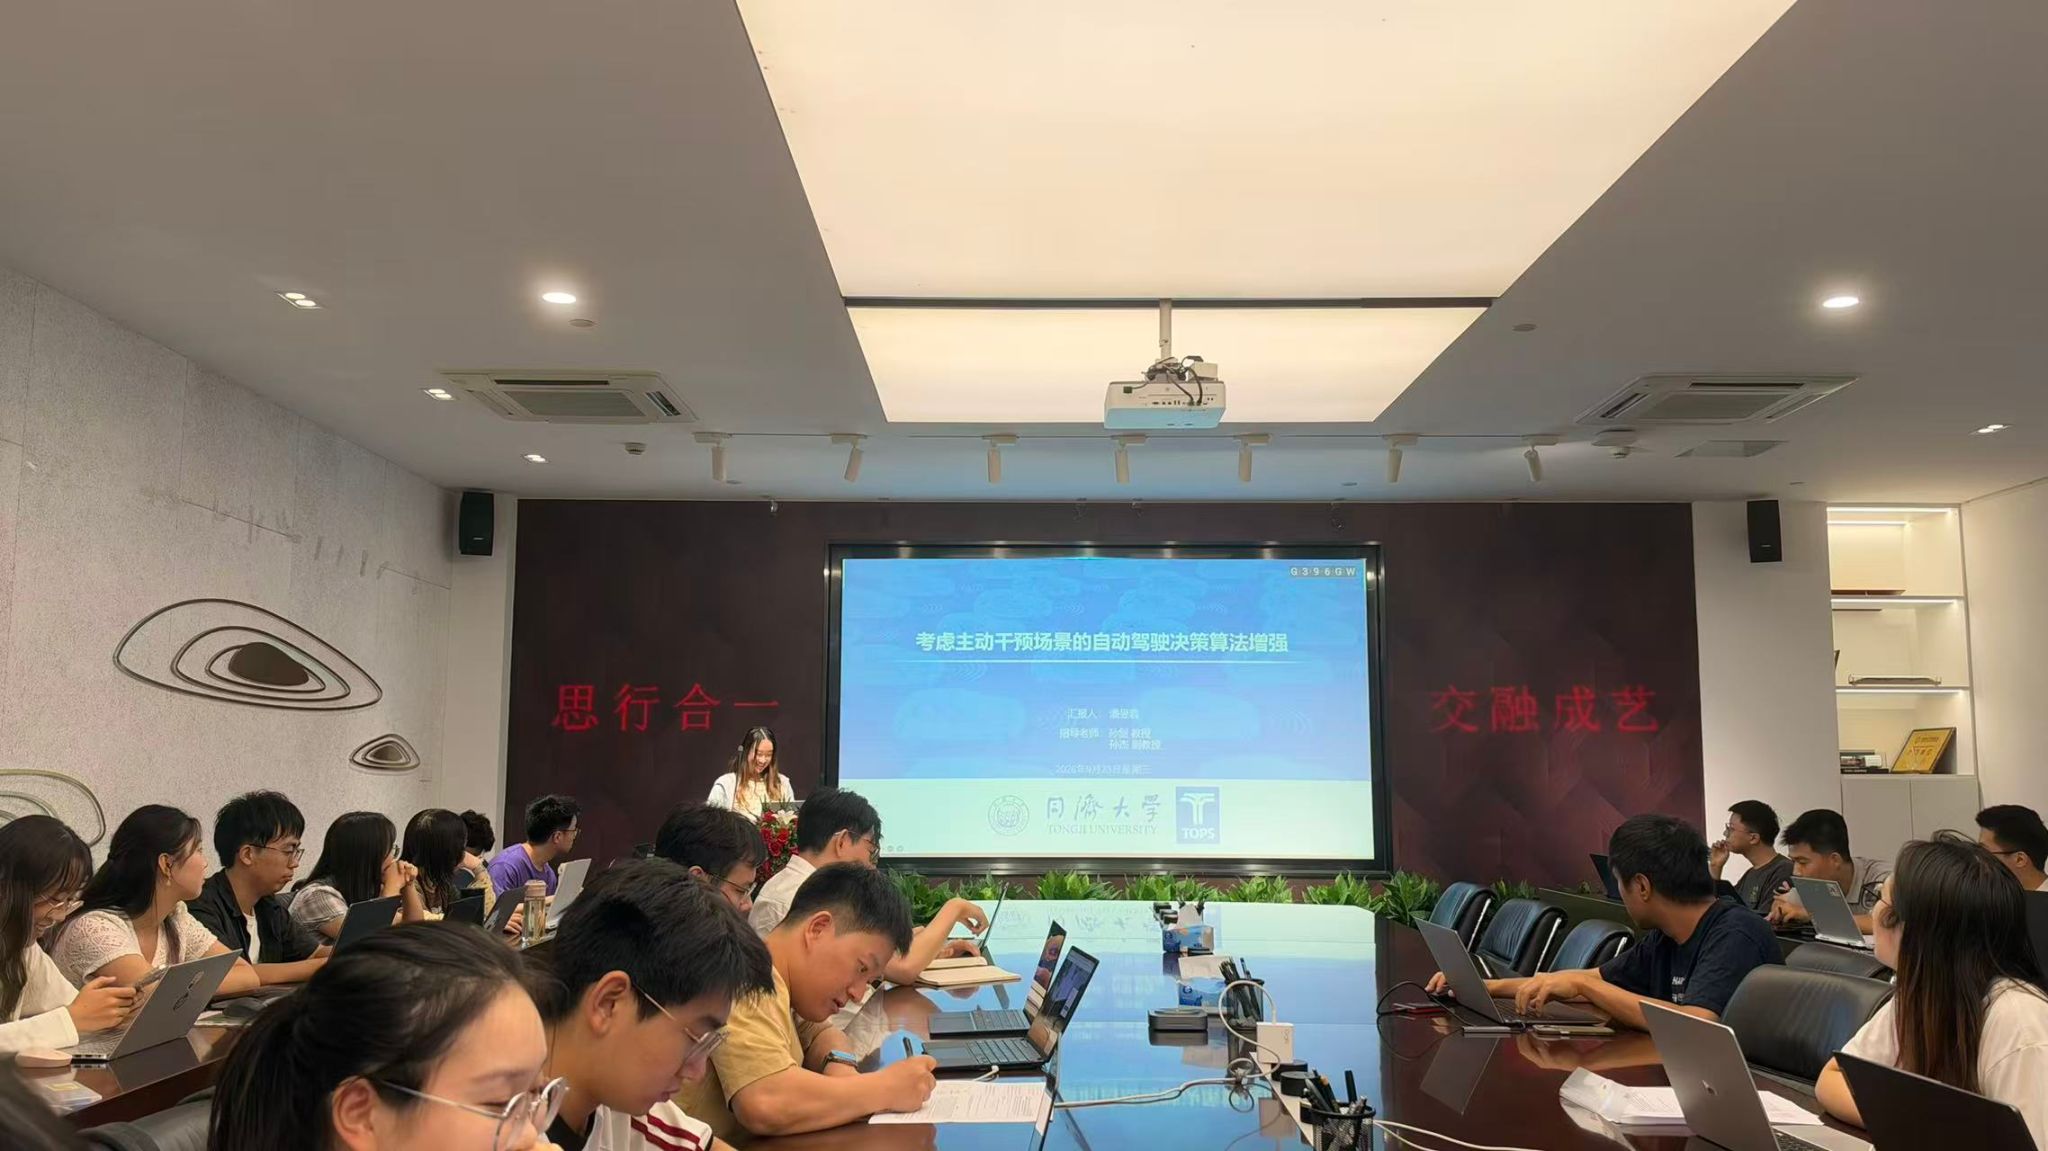
潘昱蓉同学关注人机共驾阶段驾驶员主动干预带来的安全与效率问题。由于驾驶员和自动驾驶系统对风险的认知及舒适区并不完全一致,非必要接管可能引入新的事故风险。围绕“理解主动干预、利用人类反馈优化决策”的目标,她基于HAIDO平台和CARLA构建驾驶员在环实验环境,接入CARL强化学习算法,并针对前方突发事故、左侧车辆插入和无保护交叉口左转三类场景设计了15种风险条件。研究利用接管前2秒内的TTC、THW、相对速度、最小距离及车辆状态等特征,建立场景状态到主动干预风险的映射。实验同步采集方向盘转角、油门与制动踏板输入、车辆运行状态及接管时刻,并采用分层拉丁方安排场景顺序,为比较不同风险条件下的驾驶响应和接管倾向提供数据基础。
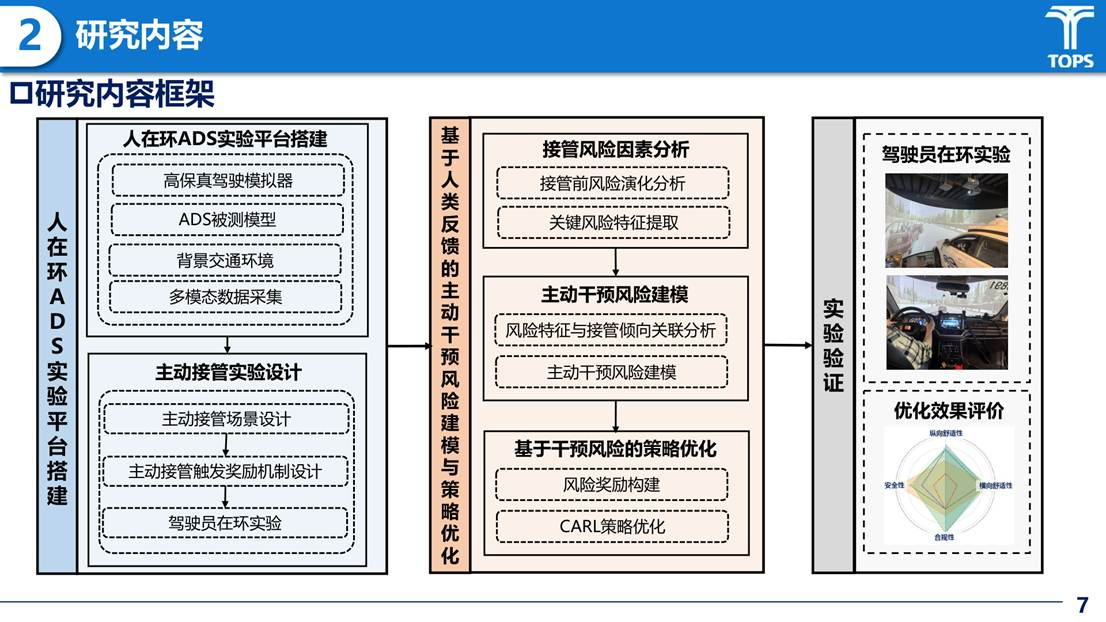
潘昱蓉同学:驾驶员主动干预研究内容框架
预实验共组织10名驾驶员并获得157组有效场景数据,其中90组发生主动干预。时序分析显示,驾驶员通常在接管前已经感知到风险并作出响应,多数样本的响应至少提前2秒。主动干预风险预测模型在“驾驶人×场景”验证中的ROC-AUC达到0.895,在未见场景和新驾驶人条件下分别达到0.880和0.918;解释分析表明,TTC及其动态变化是预测主动干预的主要因素。模型解释还显示,较小的TTC和较快的车距缩短与较高的预测接管概率相关。这些阶段性发现为识别易发生主动干预的场景、设计风险感知奖励及开展后续策略优化提供了依据。下一阶段将补充正式实验,并将预测风险构造成奖励信号,在PPO框架下对决策策略进行微调,从安全性、舒适性、效率和主动干预率等维度评价增强效果。
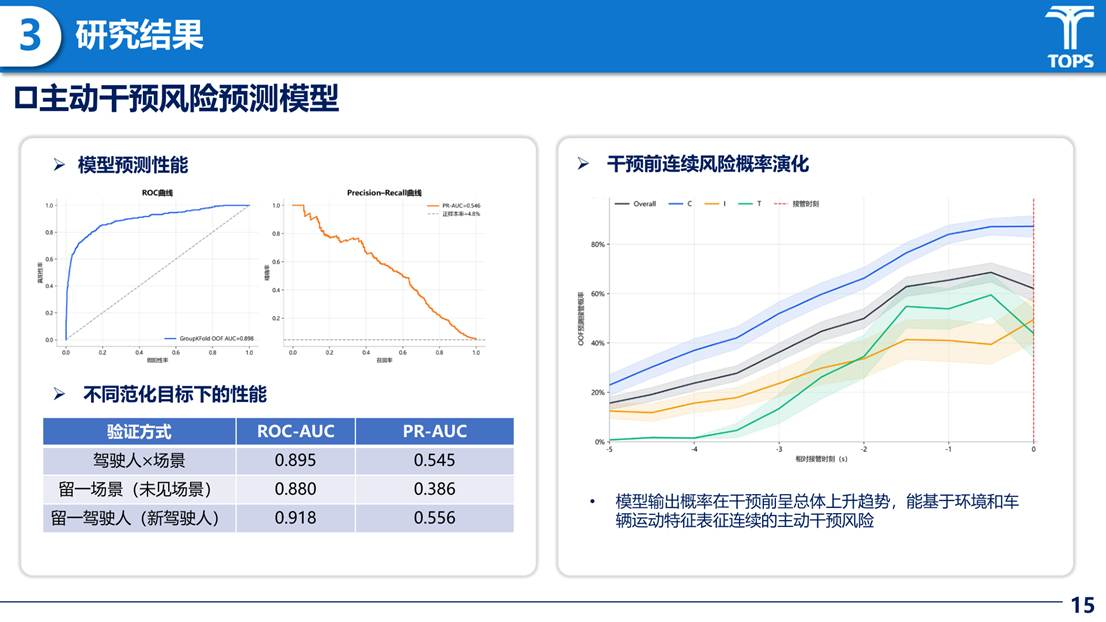
潘昱蓉同学:主动干预风险预测模型阶段性结果
连邦安(24级硕士):高度复杂交通场景交互行为建模与仿真
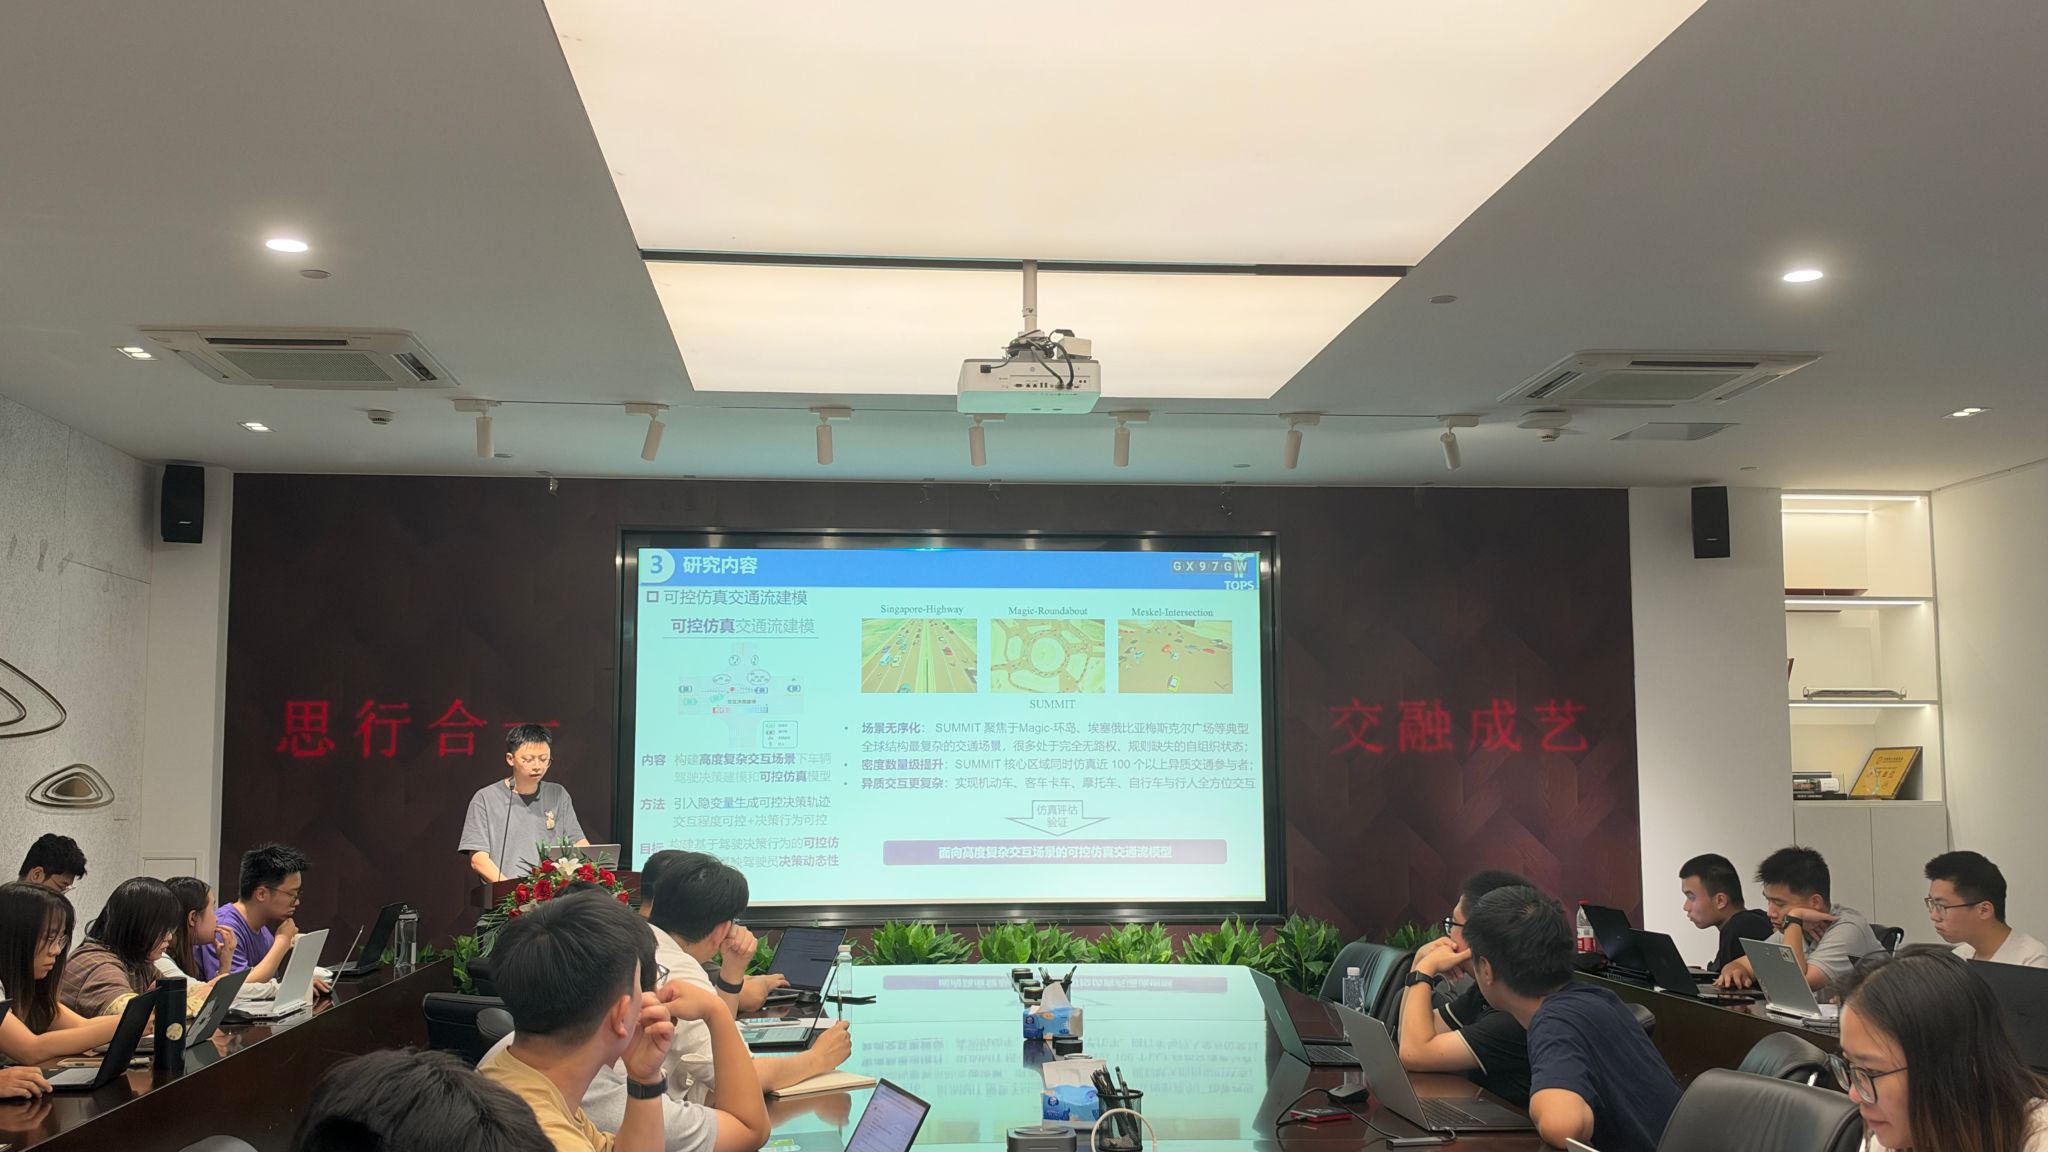
连邦安同学面向多参与者混行、规则弱化和交互高度动态的复杂交通场景,研究驾驶决策行为的建模、解析与可控仿真。以无信号交叉口左转车辆依次面对机动车、非机动车和行人的链式交互为对象,他利用速度-风险场表达安全与效率特征,并构建由CVAE和Swin Transformer组成的DecFormer模型:CVAE负责生成未来决策特征,Swin Transformer进一步捕捉连续决策点之间的时空依赖,从而输出抢行或让行的链式决策序列。该框架将驾驶决策视为贯穿交互全过程的连续过程,关注前后决策之间的相互影响,旨在揭示复杂场景中人类驾驶行为的动态演化规律,为后续仿真中的交互程度控制提供依据。
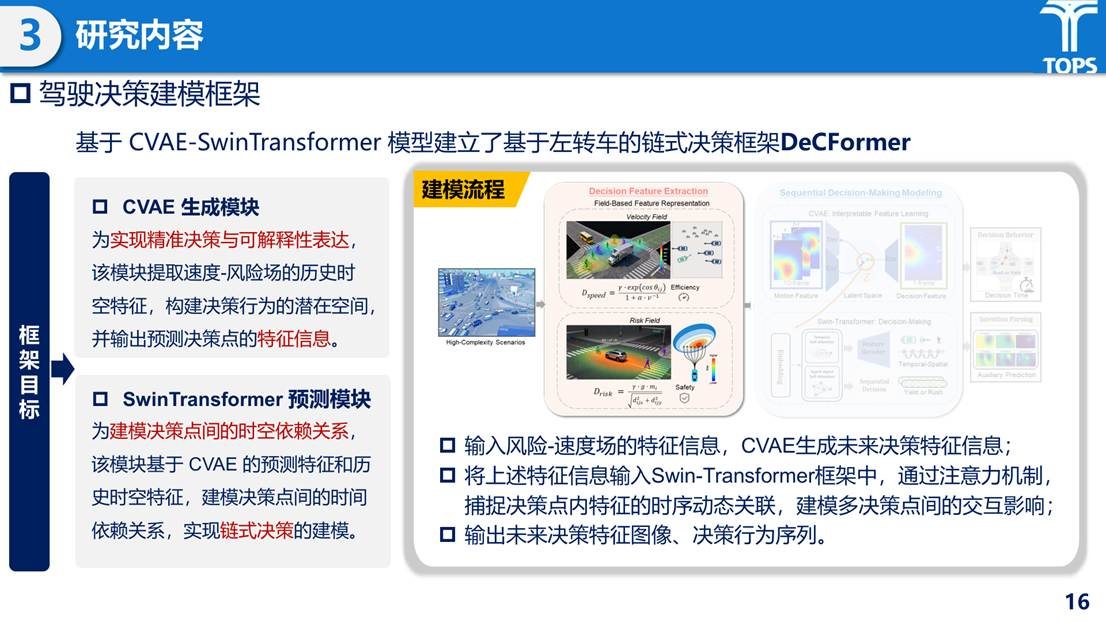
连邦安同学:DecFormer驾驶决策建模框架
研究采用团队采集的上海仙霞路—剑河路交叉口数据开展验证,共提取128个多主体交互场景。DecFormer的决策准确率达到84.78%,高于GAT、LSTM、ViT、Transformer和HMM等基线;消融结果同时验证了速度-风险场输入以及CVAE潜在空间重构对决策一致性和准确性的贡献。该项成果已形成期刊论文。后续研究将引入SAFE-SIM引导扩散模型,以决策隐变量控制轨迹去噪,并依托SUMMIT平台构建包含机动车、非机动车和行人的高度复杂仿真交通流,进一步服务自动驾驶训练与测试。进一步的隐变量分析显示,潜在表征能够区分高速度、低风险与低速度、高风险等不同决策区域,为理解抢行和让行行为提供线索。可控仿真部分仍在推进,后续计划集成至Onsite平台开展训测应用验证。
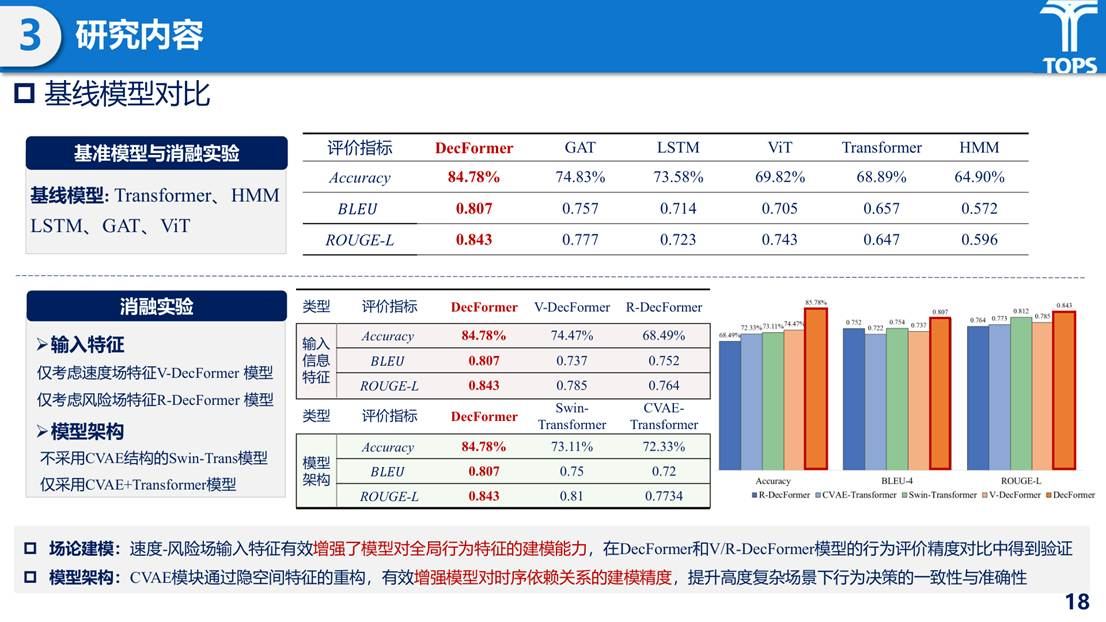
连邦安同学:DecFormer模型对比与消融实验结果
冯华越(24级硕士):面向端到端自动驾驶训测闭环的自适应场景生成方法研究
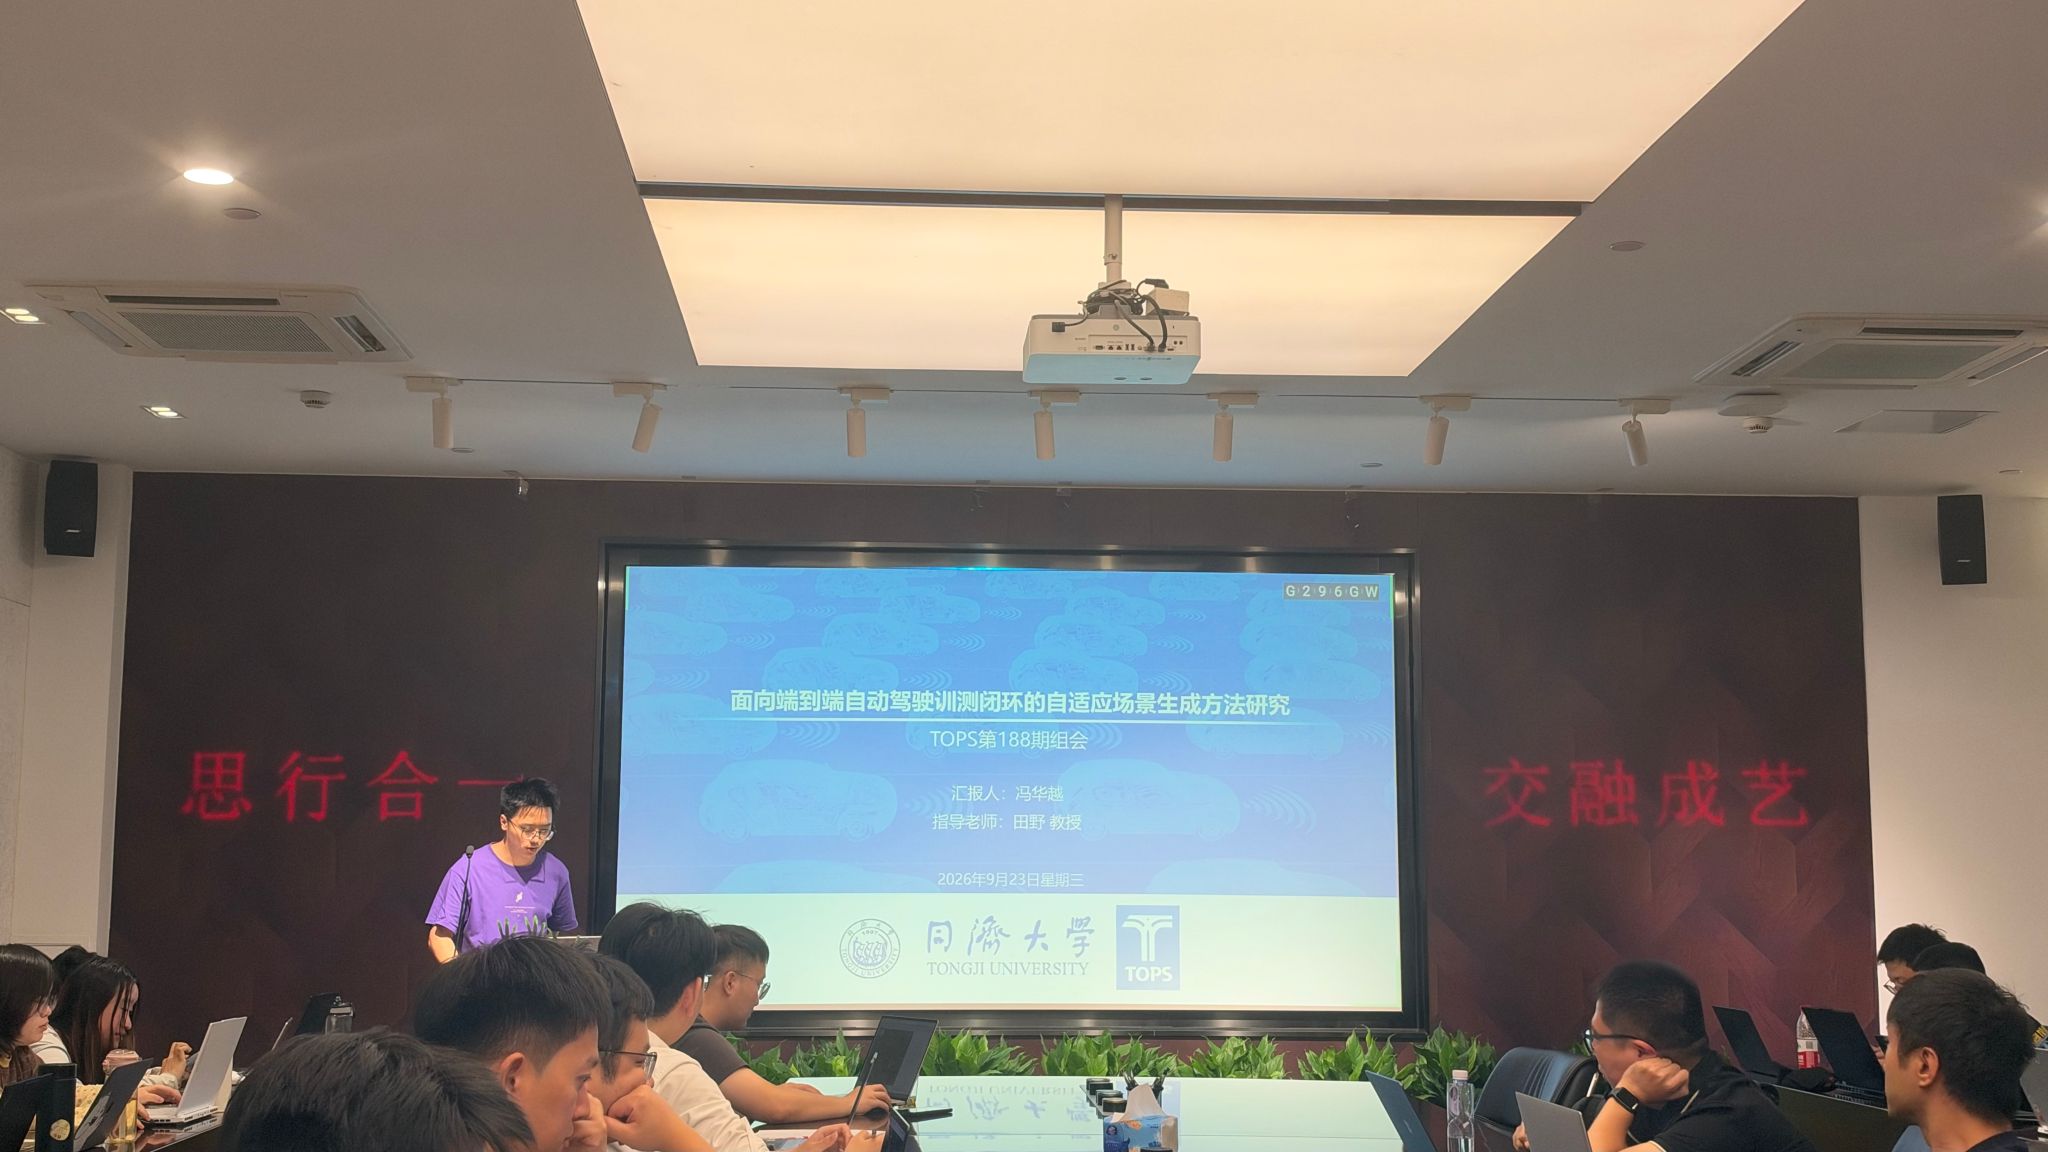
冯华越同学从端到端自动驾驶对高价值数据的需求出发,分析了现有场景生成在行为、感知和价值三个层面的缺口:安全关键场景需要兼顾可控性与多主体交互真实性,结构化行为在三维视觉实例化后需要保持原有语义,而场景训练价值还会随模型能力变化,不能仅由场景绝对危险程度决定。为此,他提出面向训测闭环的自适应场景生成框架,使场景分布与自动驾驶策略在持续反馈中协同演化。他特别强调,危险程度高的场景可能已被模型充分掌握,而接近当前能力边界的场景更有可能提供有效学习信号,因此需要结合策略表现动态判断场景价值,并随训练推进调整生成重点。
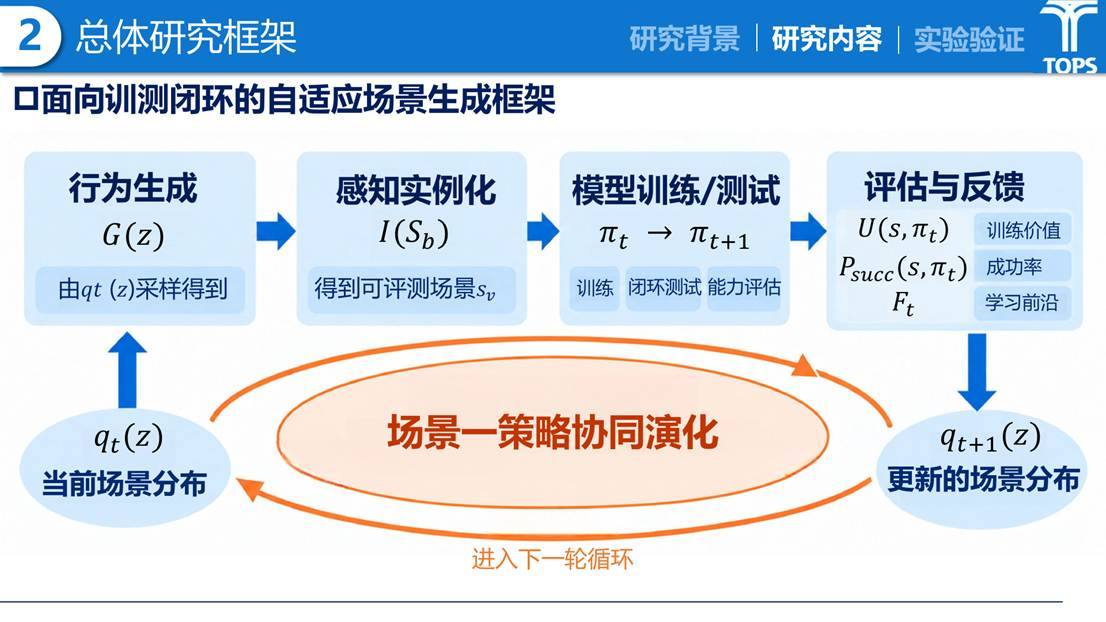
冯华越同学:面向训测闭环的自适应场景生成框架
该研究首先利用自回归多车行为先验与约束重采样,联合生成带有行为类别和激进程度标签的结构化场景;随后通过动态车辆位姿优化和跨层一致性约束,将行为场景实例化为多视角时序图像;最后依据当前策略成功率识别学习前沿,动态更新场景条件分布,从“筛选已有场景”推进到“生成当前策略真正需要的场景”。后续验证将分别考察行为控制效果与真实性、行为至几何和视觉层的一致性,以及不同生成策略下的训练效果与样本效率。在跨层一致性评价中,研究将关注碰撞时间、相对距离和让行关系等行为指标,以及车辆姿态、道路边界、时序和多视角一致性,检验场景编辑是否改变了原有交互语义。
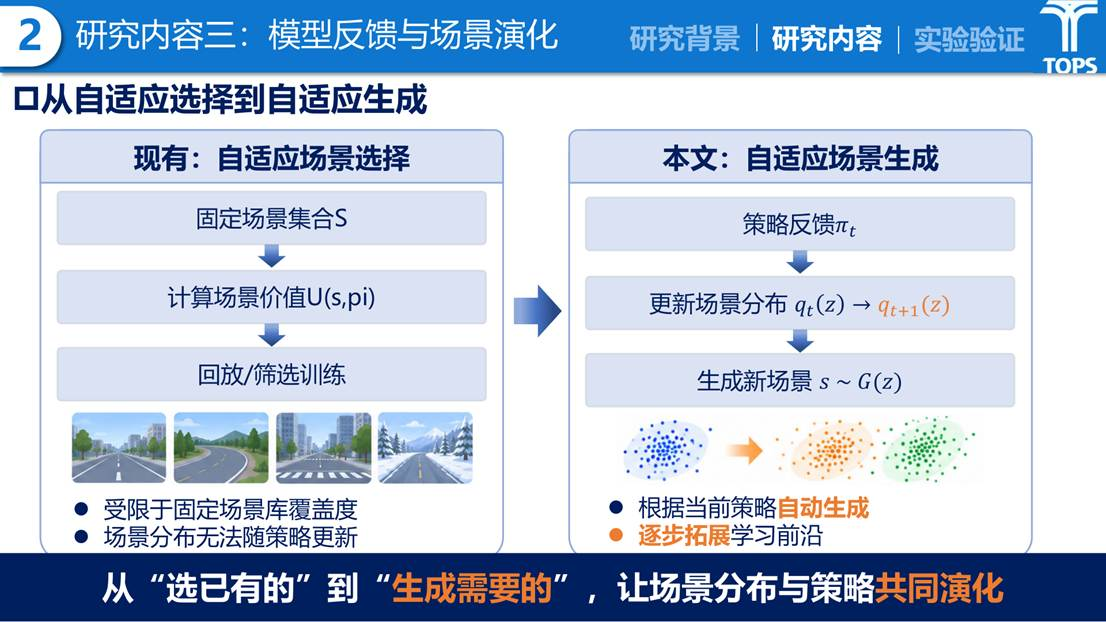
冯华越同学:从自适应场景选择到自适应场景生成
修晓煊(24级硕士):面向自动驾驶训练的跨域仿真场景迁移生成方法研究
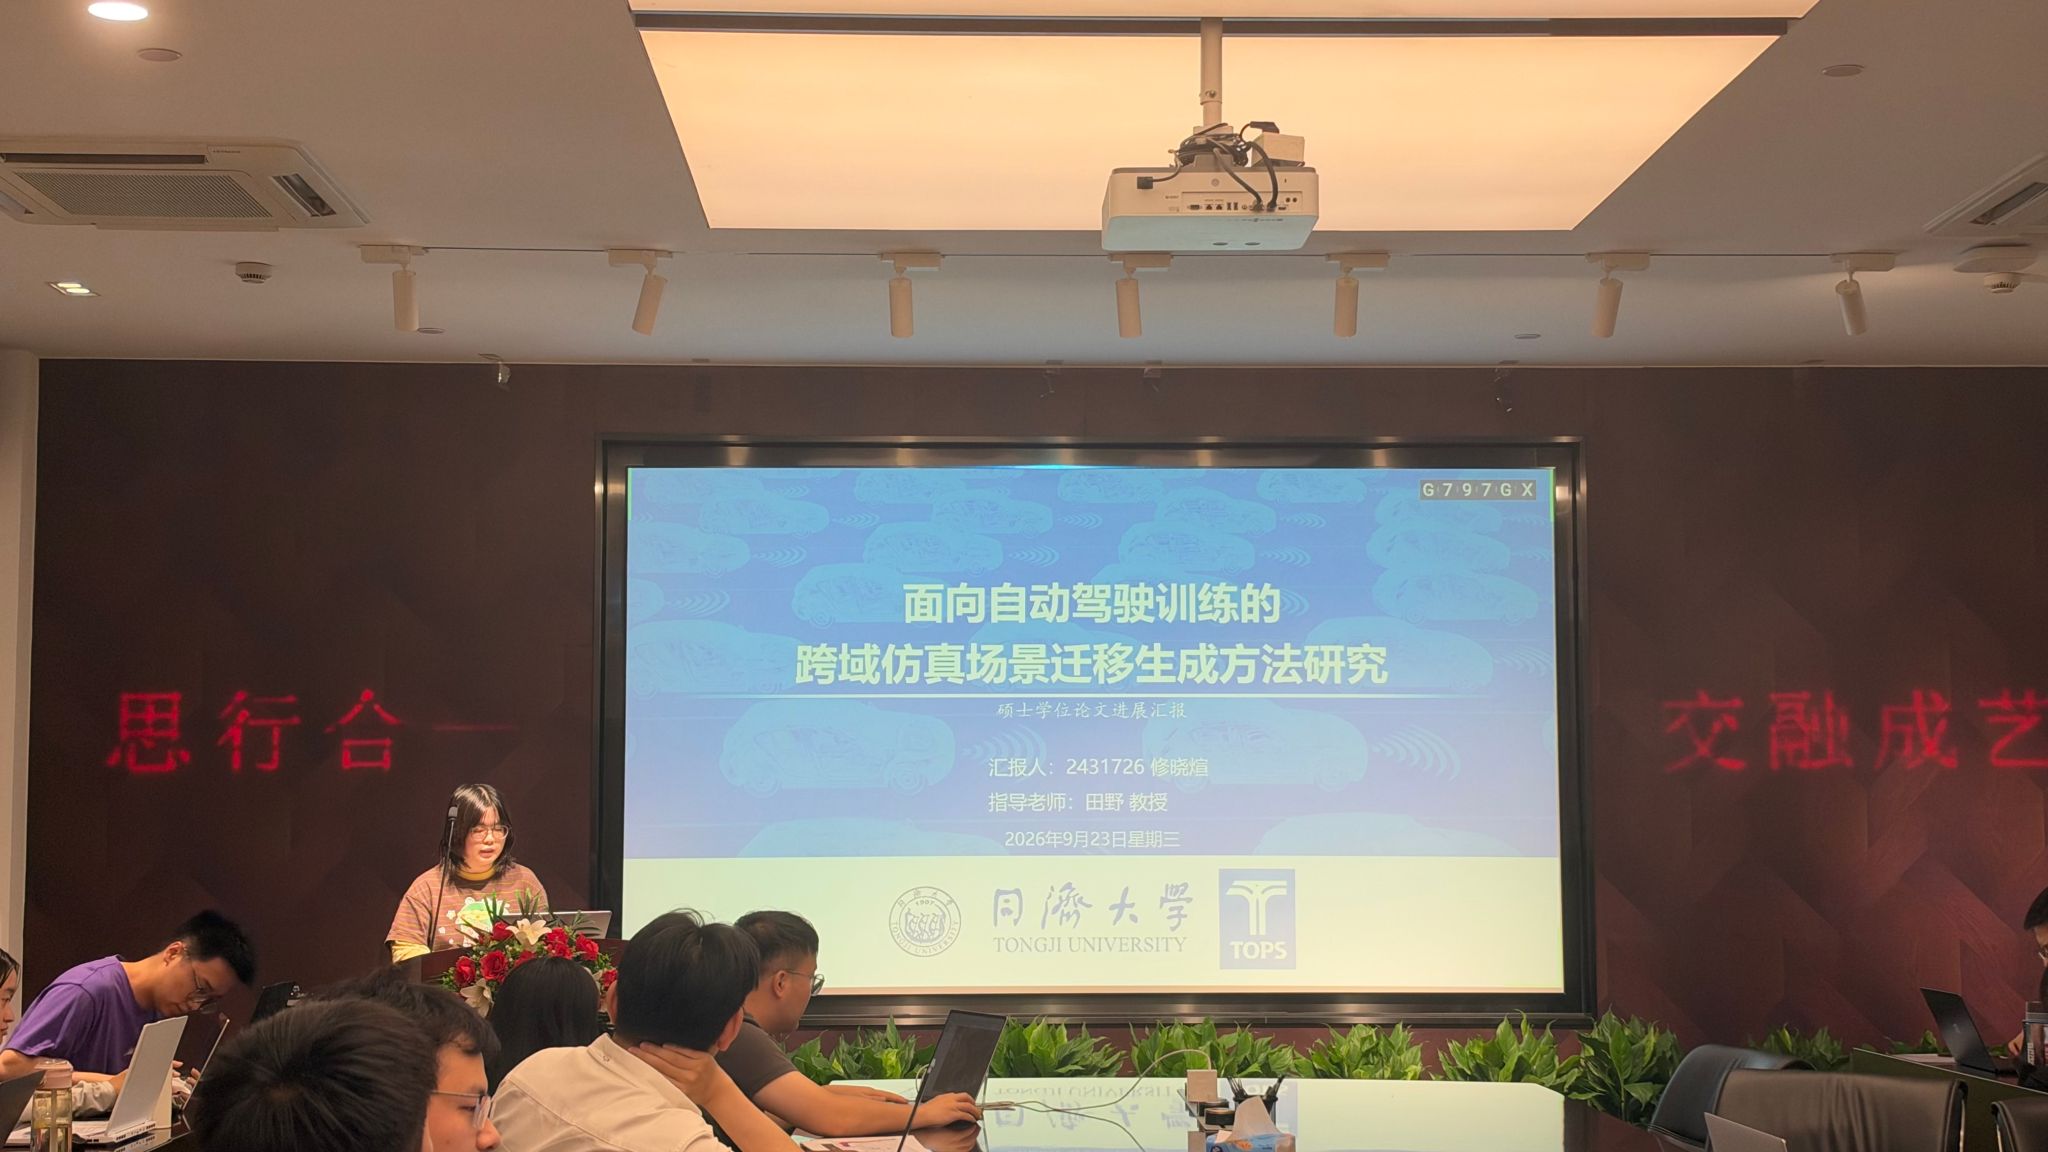
修晓煊同学聚焦国产自动驾驶系统出海过程中的跨域安全验证问题。针对国外交通数据采集受限,以及国内外道路拓扑、交通规则和驾驶风格差异导致的分布偏移,她提出在“大样本源域、小样本目标域”条件下生成真实、合理且具有关键性的目标域仿真场景。研究构建了跨域自适应条件扩散框架DACD,以场景级条件扩散模型学习多车未来联合行为分布,并通过最大均值差异对齐、域对抗特征学习和EMA自蒸馏提升小样本条件下的域不变表征能力;推理阶段则采用局部梯度引导,实现对安全约束与车辆行为的细粒度控制。其中,条件编码联合考虑车辆历史运动、邻车交互与地图语义,通过时间、交互和地图注意力刻画多车时空依赖;闭环推理则根据最新观测滚动生成未来轨迹,以反映交通参与者之间的动态响应。
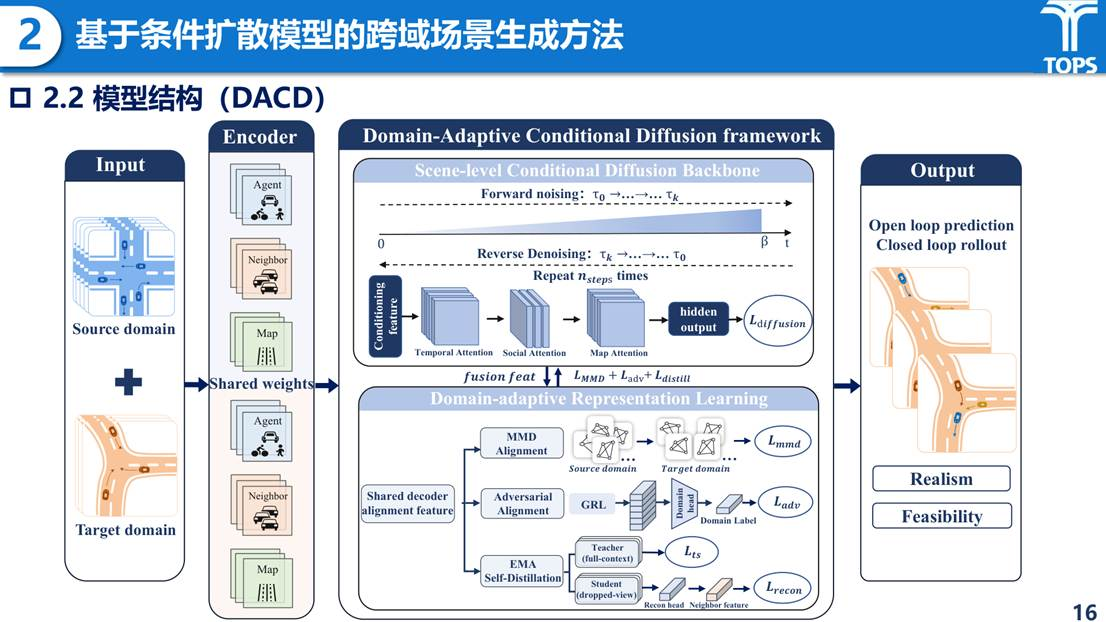
修晓煊同学:跨域自适应条件扩散模型总体框架
在波士顿至新加坡的跨域实验以及nuScenes至nuPlan的跨数据集迁移实验中,该方法在多数开环轨迹拟合与分布一致性指标上取得优势,并在闭环生成中改善真实性、合理性和失败率。下游策略训练结果进一步揭示了场景质量向训练收益传递时的性能与风险权衡:在目标域TD3实验中,DACD生成场景使碰撞率由0.608降至0.408,路线完成度由0.144提高至0.404,累计回报由-27.07提高至20.81,但驶出道路风险有所上升。她还指出,PPO策略在两类生成场景背景下的总体差异有限,尚未形成稳定优势,后续需要结合多随机种子、更密集的训练检查点和不同策略算法,进一步分析生成场景的适用条件与训练收益的稳定性。后续研究将扩展混合域场景池、生成模型和强化学习策略,并探索基于视觉语言模型的关键跨域场景靶向生成。
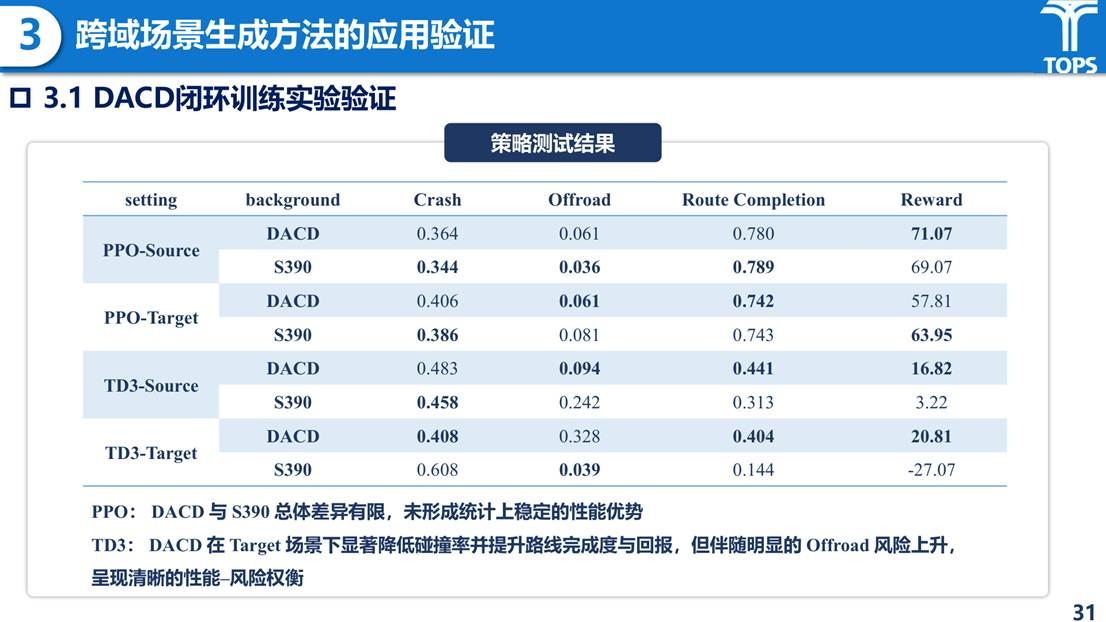
修晓煊同学:DACD闭环训练的策略测试结果
本次组会中,四位同学围绕各自的研究方向,分别汇报了问题背景、技术方案、阶段性成果及后续计划。汇报内容充分展示了研究当前的推进情况,也为各位同学进一步完善方法设计、补充实验验证和明确后续重点提供了交流机会。老师们对各位同学存在的问题以及研究进度提出宝贵的建议与意见,整场组会在严谨、充分的学术氛围中顺利结束。
电话:021-69583650 管理员邮箱:2015qgy@tongji.edu.cn
地址:上海市曹安公路4800号同济大学交通学院 邮编:201804
 TOPS课题组 页面浏览465,829次/访客70,123人次


