第一次打开一个陌生的开源项目,我们往往会下意识地寻找 README.md:环境如何配置?代码如何运行?第一步做什么?遇到问题去哪里找答案?
但科研没有这样一份现成的 README。
导师给出的一个方向、几篇论文、一个模糊的想法,往往就是科研最初的全部“输入”。从这里出发,如何找到真正值得研究的问题?如何判断下一步该往哪里走?一次实验失败意味着方向错了吗?AI 越来越强之后,科研训练真正重要的又是什么?
如果把科研看成一次漫长的优化过程,那么我们面对的或许不是一道拥有标准答案的题,而是一条需要自己不断寻找“梯度”的 Loss 曲线:
Define Loss → Estimate Gradient → Run the Loop → Choose Convergence
科研没有精确的梯度,也没有唯一的最优路径。但我们可以在一次次反馈中修正方向,在一次次迭代中更新自己,最终逐渐形成属于自己的科研工作流。
01 Define Loss
第一步不是找方法,而是先知道自己到底在优化什么
新生刚入课题组时,可能会说:“我想做自动驾驶。”“我想研究大模型。”“我想做交通仿真。”
这些可以是一个很好的起点,却还不是一个真正意义上的科研问题。
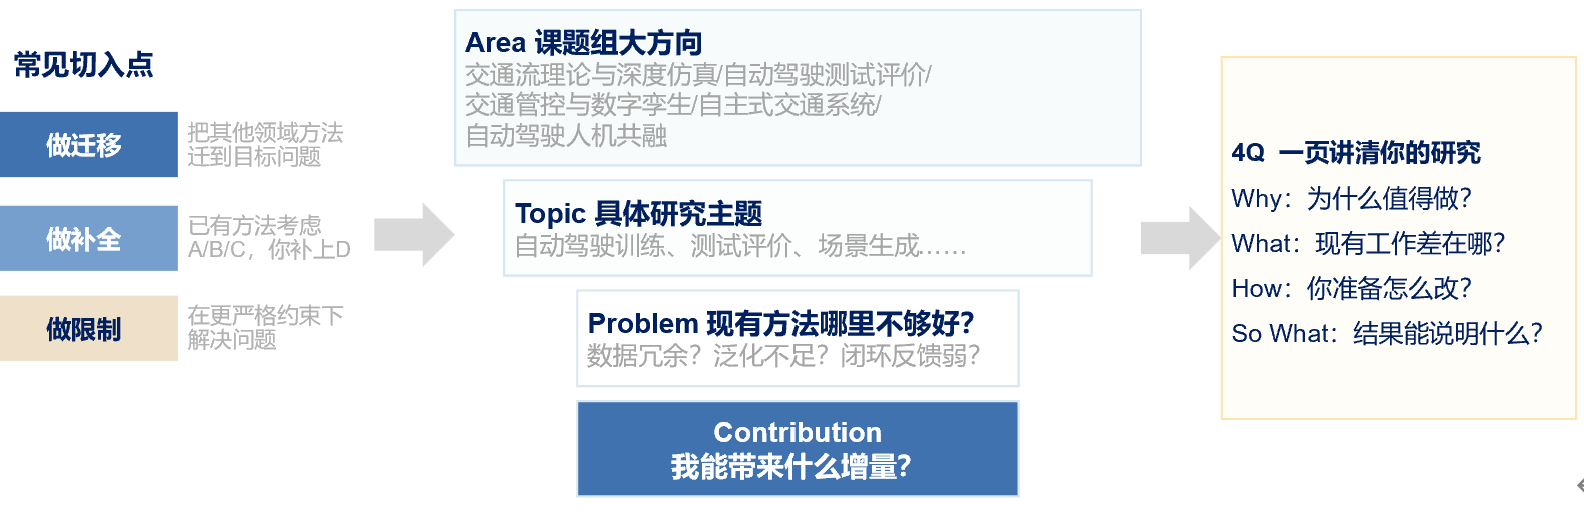
科研,首先需要区分四个逐渐收敛的层次:
Research Area → Topic → Problem → Contribution
课题组的研究方向可以是自动驾驶测试评价、自主式交通系统、交通管控与数字孪生等;进一步缩小,可以形成自动驾驶训练、测试评价、场景生成等具体主题
但科研真正开始的地方,是继续追问:
现有方法到底哪里不够好?
是数据存在大量冗余?模型泛化能力不足?还是闭环反馈不够充分?
只有继续把“大方向”压缩成一个可以阅读、可以讨论、可以实验、可以被证伪的问题,才有可能进一步讨论自己究竟能够带来怎样的研究增量。
对此,我们提出了一个简单的 4Q 检查方法:
Why —— 为什么这个问题值得研究?
What —— 现有工作究竟差在哪里?
How —— 准备通过什么方式解决?
So What —— 如果实验成功,它究竟说明了什么?
后一个问题尤其容易被忽略。
科研并不只是让某个指标提高一点。更重要的是,这个结果究竟验证了一个新的规律,解决了一个此前没有解决的问题,还是只是在已有框架上增加了更多模块。
把“方向”变成一个可验证的问题,科研才真正开始。
02 Estimate Gradient
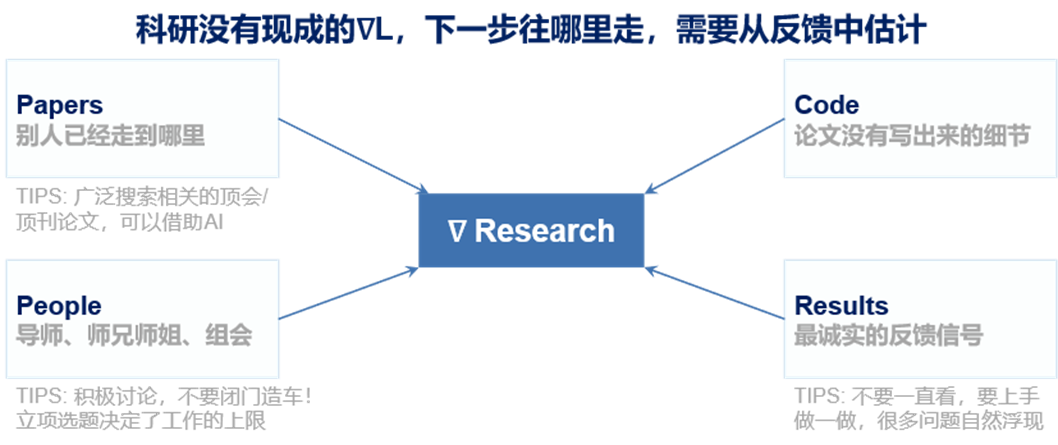
科研没有现成的 ,只能不断从反馈中估计方向
问题确定以后,新的困难随之出现:
知道自己想去哪里之后,下一步究竟应该怎么走?
优化算法可以计算梯度,但科研没有一个函数能够直接告诉我们下一步应该更新哪一个参数。
我们将科研中的“Gradient”概括为四类重要信号:
Papers、Code、People、Results。
论文告诉我们别人已经走到了哪里;代码补充论文中没有完全呈现的实现细节;导师、师兄师姐和组会讨论提供来自他人的视角;实验结果则不断检验我们原本对于问题的理解。
其中,一个重要观点是:
文献不是“收藏夹游戏”
科研阅读的目标不是“我看过多少篇论文”,而应当是:
读完之后,我的不确定性减少了多少?
因此,文献阅读可以形成这样一个循环:
扫描 → 精读 → 复现 → 讨论
先通过关键词和顶会顶刊快速建立领域地图;再围绕 Problem、Method、Experiment 和 Limitation 精读真正相关的工作;随后尽可能跑通一个 baseline,在实践中发现论文文字之外的问题;最后带着已经具体化的问题,与导师和同学讨论。
所以,一批文献真正被吸收的标志,不是 Zotero 中多了多少个 PDF,而是:
我开始知道,下一步想验证什么。
文献阅读的终点,应当是形成自己的下一步假设。
03 Run the Loop
不等待一次“大跃迁”,而是让小更新不断发生
找到了目标,也获得了一些“梯度”,接下来最重要的事情反而非常朴素:
把循环真正跑起来。
科研进展很少来自某一天突然出现的灵感,更多时候来自许多不起眼的小更新不断累积。
因此,虽然科研本身没有 README,却可以逐渐给自己的科研写一份:
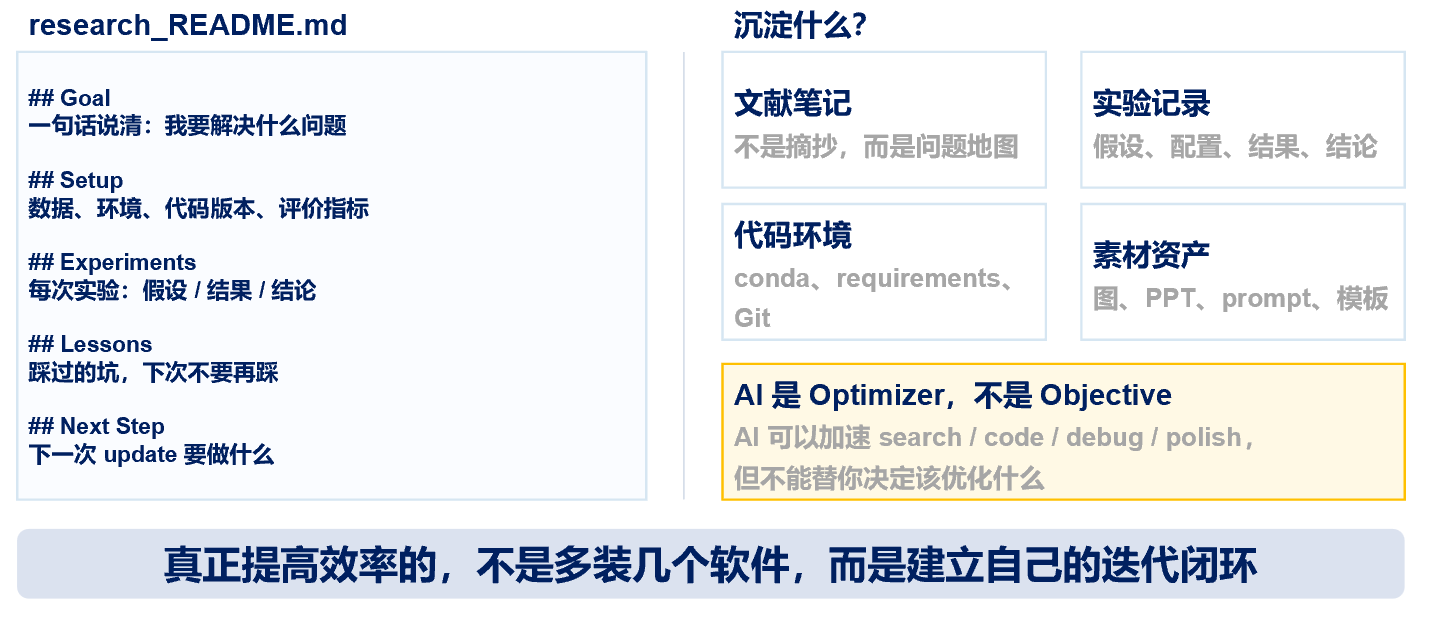
research_README.md
里面至少可以有五个部分:
Goal:一句话说清楚:我现在究竟在解决什么问题?
Setup:数据、实验环境、代码版本和评价指标是什么?
Experiments:每次实验为什么做?结果是什么?结果改变了什么判断?
Lessons:踩过哪些坑?哪些问题不应该再次重复?
Next Step:下一次 update 准备做什么?
这份 README 的价值,不在于把科研记录得多么“漂亮”,而在于让每一次尝试都能够为下一次迭代留下信息。
文献笔记沉淀的是问题地图;实验记录沉淀的是假设—配置—结果—结论;代码环境留下可复现的版本信息;图、PPT、Prompt 和模板则逐渐成为自己的科研素材资产。
记录同样也是一种 self-improve。
今天需要三天才能解决的问题,几个月后也许半小时就能够处理;曾经难以理解的论文,经过一段时间积累之后可能已经成为常识。
因此,比“今天完成了多少任务”更加重要的问题是:
我的迭代方向对不对?
哪些事情已经不值得再投入这么多时间?
下一阶段真正的瓶颈变成了什么?
04 Choose Convergence
效率最终会趋同,判断决定上限
代码可以越写越快,实验可以越来越熟练,文献也可以越读越快。
但分享中特别强调,还有一种能力很难通过简单重复获得:
判断。
首先是判断,什么问题值得花半年甚至一年去做。
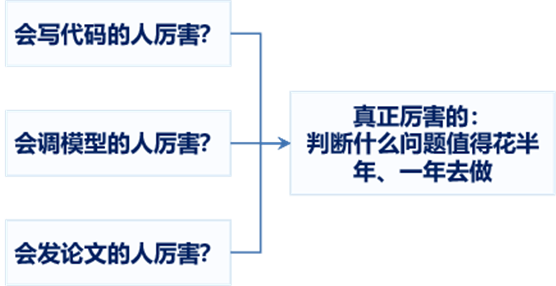
分享用一个简单的乘法表达一个值得投入的问题:
Good Problem = Important × Interesting × Tractable
它应该具有研究价值,能够持续激发自己的兴趣,同时又需要在现实的数据、算力、时间和能力约束下具有可执行性。
其次,是判断应该如何看待实验,也如何看待自己。
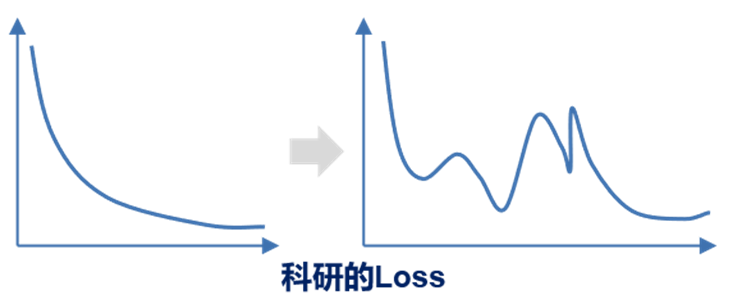
真实的科研 Loss 曲线很少平滑下降。
一个实验失败,不足以证明一个 idea 不成立;某一天没有进展,也不足以判断一个人的科研能力。
因此:
不要用一天评价自己,用一个月评价自己。
不要用一次实验评价一个 idea,用一组证据评价它。
不要因为一次 Loss 上升,就 Early Stop。
科研最终训练的,也许正是在充满噪声的反馈中,仍然能够逐渐形成独立判断的能力。
05 AI is Optimizer, not Objective
工具解决摩擦,但不替你决定方向
今天的科研正在发生一个明显变化。
AI 可以帮助我们检索文献、编写代码、调试程序、整理材料和润色文字;越来越多工具,也正在持续降低科研中的重复劳动成本。
但我们认为,仍然存在一个值得警惕的区分:
AI is Optimizer, not Objective.
AI 可以让一个已经确定的想法执行得更快,却不能天然替代研究者回答:
究竟什么问题值得做?
当“执行一个想法”的成本不断下降,“决定什么值得执行”的能力反而变得更加重要。
同样,Illustrator、Photoshop、Procreate、PPT以及各种 Agent,都只是降低科研摩擦的工具。文件管理、文献管理、绘图和时间管理的最终目的,也不是建立一套看起来复杂而精致的“效率系统”。
工具解决的是摩擦,不解决方向。
真正有价值的工具,应当把我们从重复劳动中释放出来,让时间重新回到阅读、思考、实验与讨论之中。
写在最后
Research has no README. So write your own.
科研没有标准答案。
没有人能够提前告诉我们,哪一个问题一定能够做成,哪一个方向一定值得坚持,也不会有一个 debug.log 清楚地告诉我们究竟在哪一步出了问题。
但科研的意义或许也正在这里。
我们可以不断重新定义自己的 Loss,从论文、代码、实验和讨论中估计 Gradient,在一次次 Update 中修正自己的认识,并最终逐渐形成关于研究问题、方法与方向的独立判断。
于是,那份一开始并不存在的 README,也在这个过程中被一点点写了出来。
它没有最终版本。
因为科研本身,就是持续更新它的过程。
科研没有 README。
So write your own.
电话:021-69583650 管理员邮箱:2015qgy@tongji.edu.cn
地址:上海市曹安公路4800号同济大学交通学院 邮编:201804
 TOPS课题组 页面浏览465,829次/访客70,123人次


